
解耦:让模型、算法、后端与算子独立演进
zLLM 如何把模型规格、完整模型运行时、领域语义、后端能力与设备实现分开,让平台 backend 和参数化 kernel 作为并列轨道独立演进。
日期:2026-08-28 初稿;2026-09-01 重写。本文基于当前源码中的 model_spec/、
runtime/、backend/、kernel/、weight/ 与 server/ 整理,描述已经存在的
依赖边界,不把尚未落地的通用 Planner 或远端 Expert RPC 写成现状。
zLLM 的解耦目标不是“目录看起来整齐”,而是让变化沿正确的轴发生:模型架构变化 主要进入 spec 与 runtime,新的数学语义先进入领域层,设备差异停在 backend,局部 性能优化落到 kernel。一次完整推理仍由这些层共同完成,但任何一层都不需要知道 所有下层实现。
1. 分层全景
主依赖沿中轴自上而下。权重格式是一条侧向数据通道:model_spec 提供 shape,
weight 解析文件与编码,backend 决定最终 resident 形态;它不反向控制模型编排。
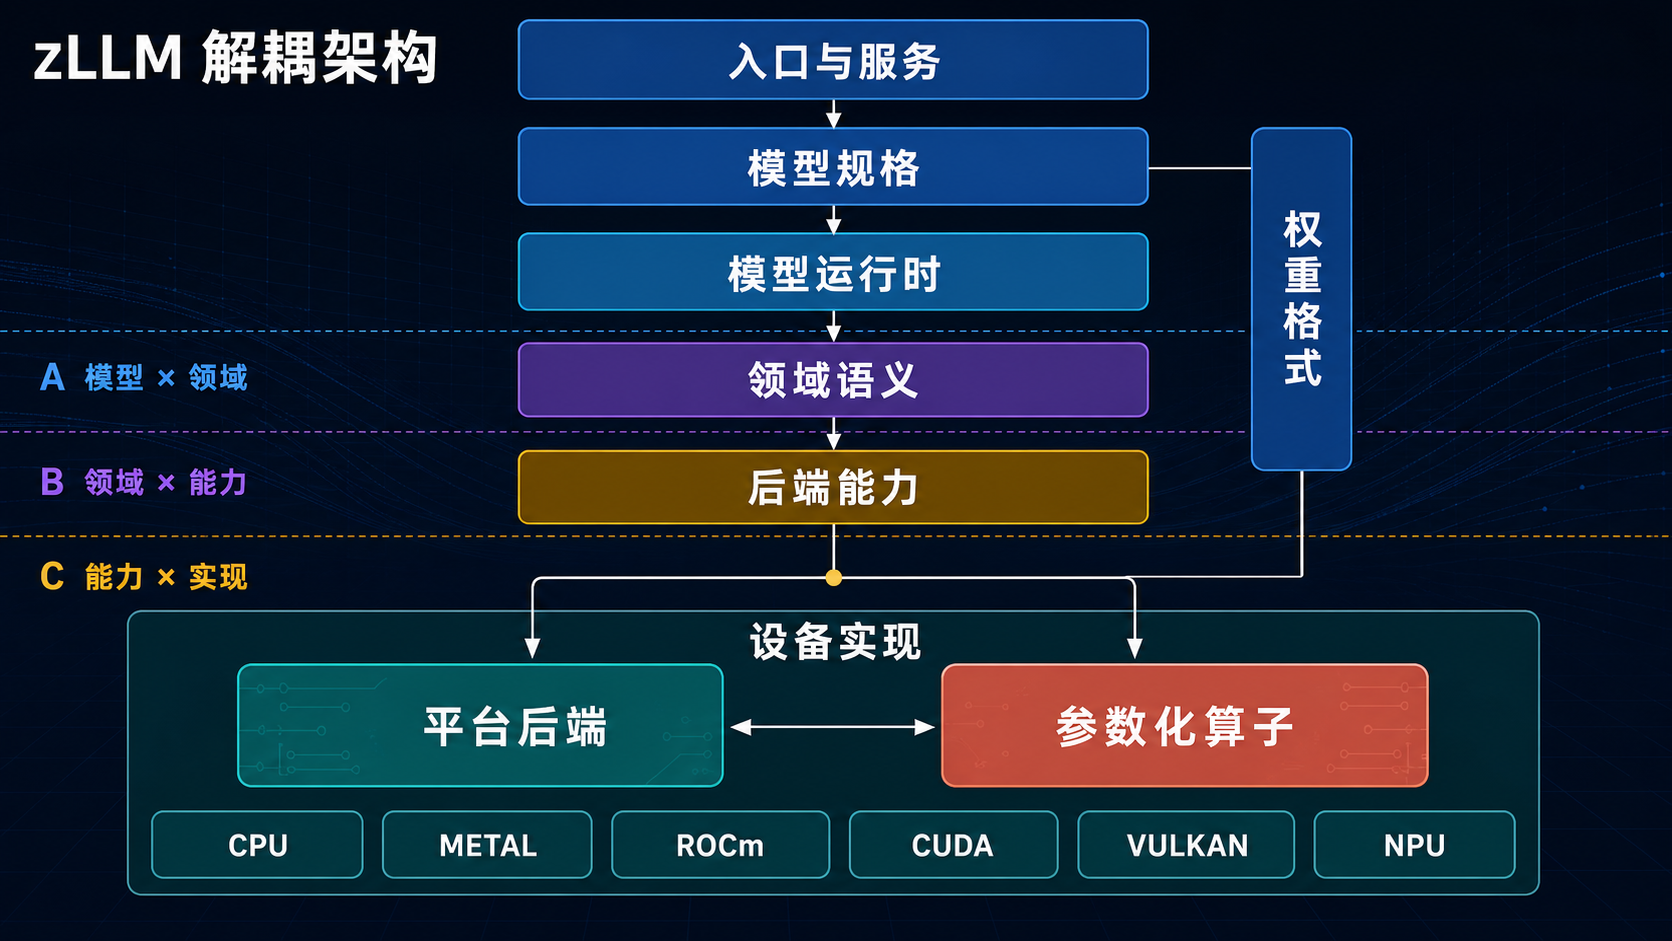
图中的五层主干和一个设备实现区域不是六个运行时进程,而是六类职责。设备实现
内部,backend/<platform> 与 kernel/<platform> 是并列协作关系:前者管理
tensor、权重、cache、提交和迁移,后者实现参数化局部计算;两者共同兑现上层
capability,而不是 backend 层层调用一个更低级的 kernel“平台”。生产请求仍然执行完整的
New Prefill、Append Prefill 或 Decode Round;解耦只改变代码依赖与资源所有权,
不把完整模型拆成彼此不知道上下文的局部演示流程。
各层一句话职责(与 README "核心边界"一致):
- bin/runtime、bin/tools:平台入口组合,一切
--config <yaml>驱动;无模型 专属、验证或 profiling binary(验证与性能归独立的 zllm-bench 项目) - embedded:进程内
Engine,复用与服务模式相同的结构化 JSON 语义,不启动 HTTP、scheduler 或 iroh(详见 06 篇 §6) - server/:HTTP/H3 协议(Chat / Anthropic / Responses)、node、scheduler 与 iroh stage transport;网络服务生命周期不散落在 crate 根或模型 runtime
- model_spec/<model>:平台与执行无关的架构配置——Config 纯常量,自身零 依赖;是 runtime 编排与 weight 装配共同依赖的单一规格定义
- runtime/<model>:LayerSpec 展开、平台无关执行编排与同目录
<backend>_*.rs平台组合;Config 经 re-export 保持定义靠近使用点 - attention/、moe/、kv_cache/、norm.rs:领域规格、通用算法与 f32 reference 语义(设备无关)
- backend/:平台资源、cache、completion、stream/command buffer、驻留与调度; 按 capability 和数据格式选择 kernel
- kernel/:参数化算子,模型维度不得硬编码;ROCm 的 HIP 主体已拆成独立
source.hip,Rust launcher 负责加载、校验与提交 - weight/:标准格式解析与生命周期;模型专属部分只做命名 / shape 适配
2. 依赖规则(强制的方向)
runtime::prefill等通用调度不依赖具体模型或具体 backendmodel_spec只含架构常量,不依赖 crate 内任何模块;runtime 与 weight 都 依赖它,彼此之间不互相依赖runtime/<model>/mod.rs平台无关算法只依赖 capability trait;同目录<backend>_*.rs才允许依赖具体平台backend/与kernel/不依赖、命名或分支到具体模型;双卡 cooperative MoE、Metal replay 等优化只能表达设备能力,不能把 GLM 层号写进 kernel- 领域层(attention/moe/kv_cache)只存规格/算法/reference;具体存储、kernel、 同步在 backend
- weight/ 只做格式解析与加载;算法不进权重目录,平台资源不进格式解析
违反方向通常意味着依赖倒挂。例外必须是明确的平台组合文件或可测量的真实执行 路径,不能为了“将来也许复用”增加空 flow、factory 或多层协议。
3. 解耦的三个交界面
| 交界面 | 上游表达 | 下游承担 | 当前约束 |
|---|---|---|---|
| A · 模型 × 领域 | layer 数据流、完整 prefill/decode 顺序 | attention、MoE、KV 等数学语义与 reference | 新语义先有可验证定义,再写设备加速 |
| B · 领域 × 后端 | where 子句声明所需 capability | tensor/cache/权重驻留、提交和迁移 | runtime 不接触 HIP event 或 Metal command buffer |
| C · 能力 × 实现 | capability 与资源生命周期契约 | 并列的平台 backend 和参数化 kernel | 两条轨道共同实现能力;kernel 无模型名和模型常量 |
交界面 A:模型 × 领域。模型编排层调用领域层纯函数(如
attention::dsa::select_rows、moe::topk_moe::decode_shared_experts),并把
backend 作为泛型参数传入——领域算法描述"做什么",backend 决定"怎么做"。
新算子(如 kpool)先进领域层钉语义 + 单测,后端的 GPU kernel 只是 reference
的加速替身;跨后端一致性(CPU oracle,atol=rtol=1e-2)保证语义不漂移。
交界面 B:领域 × 后端(capability trait)。Backend 基础 trait 只放全
模型共用算子;领域能力拆成独立 trait(KdaKernel、HyperConnectionKernel、
DsaPrefillBackend、ExpertPrefillBackend...),模型层的 where 子句精确声明
所需能力集。新能力以默认拒绝进入——如 append_dsa_keys_gated 默认返回
"backend 未实现 kpool 打包追加"错误——不强迫既有后端同步实现。
交界面 C:能力 × 设备实现。backend/<platform> 与 kernel/<platform>
位于边界的同一侧且彼此并列。backend 持有资源、resident 表示、shape/format
分派和提交语义;kernel 持有参数化的局部计算。权重经 LinearWeight 枚举
(F32 / F16 / Bf16Bytes / Quantized,后者覆盖 FP8、MXFP8、MXFP4、NVFP4、
W4A16、W8A16、GGUF 等量化族)进入设备实现,backend 的 linear() 选择同平台
kernel;量化路径在 kernel 内解码,不展开 F32。这里是协作关系,不是架构层级。
4. 关键决策与依据
| 决策 | 依据 |
|---|---|
| 不设行为型薄 model 层;Config 作为纯常量收敛进 model_spec/ | 编排(runtime)与装配(weight)共同依赖单一规格定义,二者因此不互相依赖;model_spec 只有数据没有行为,不是旧"薄 model 层"的复活。LayerSpec 展开与编排仍在 runtime/<model>,定义靠近使用点 |
| associated types(Tensor/Weight/Cache)而非统一对象 | 后端间 tensor 形态差异是本质的(CPU 值/Metal 句柄/ROCm 双态);统一对象必然 Arc<dyn>+最低公分母 |
| capability trait 按领域拆分 | 模型依赖面可读;新领域能力渐进进入不破坏存量 |
| CPU 是 oracle,reference 先行 | 跨后端一致性可测(atol=rtol=1e-2);GPU kernel 可疑时退化 reference 继续跑,正确性不阻塞工程 |
| 唯一执行流程在 runtime,平台组合在模型目录内 | 避免 N 模型 × M 平台的复制;glm53_flash 的 rocm_node.rs 是"组合"而非"另一份流程" |
| 无模型专属 binary,一切 --config yaml 驱动 | 入口收敛;验证/profiling 归 zllm-bench 项目 |
5. 优势
- 组合扩展线性化:新模型 × 既有算子 = 零后端代码;新算子 × 新后端 = 一个 kernel 文件 + 一个 trait 实现。GLM-5.3-Flash(mHC + KDA + kpool 三个 新领域件)从零到 Amd-1 八卡真机 prefill 数日,再扩到双机 16 卡持续 stage,是这条曲线的直接验证。
- 正确性有锚:reference 与单测先行;ROCm kpool 第一版"全量注意力 退化"能上真机先跑通,语义由 CPU reference 钉死,性能后补。
- 平台演进互不阻塞:Metal 的优化(minicpm5 异步流水、q6k 向量化)、 ROCm 的 stage 流水、CUDA 与华为 NPU AscendC 算子的接入并行推进,互不 污染。
- 审计边界清晰:依赖规则使"谁该改哪"几乎唯一确定,评审成本随规模 增长慢。
6. 代价与劣势(诚实清单)
- kernel 语义 N 份实现:Rust reference + MSL + HIP + CUDA + AscendC, 热门路径每个后端都要高性能版,绝对工作量不小。
- 泛型实例化膨胀:每模型编排对每后端实例化;capability 叠加后 where 子句变长,编译时间与二进制体积付出代价。
- trait 蔓延需要自律:每个新架构概念都倾向往共享 trait 加方法,"基础 Backend 保持最小"靠 AGENTS.md 纪律维持而非机制保证。
- 跨后端行为差异要文档化:同一算子退化路径不同(如 nope-MLA 零宽 split,CPU 通过、ROCm 拒绝),散在实现注释,集中索引依赖本系列文档。
7. 系列导航
- 02 模型层:格式支持 / Config / 权重装配 / 量化
- 03 算法层:attention 家族 / MoE / KV cache / prefill / decode 编排
- 04 backend:设备抽象 / 资源与提交 / 各平台特性
- 05 算子:基础与融合算子 / 精度选择 / 硬件映射 / 并行基础
- 06 服务层:围栏 / 协议 / 输入输出;§6 嵌入式库形态
(
zllm::Engine,进程内 generate(json)) - 07 多节点:scheduler / 负载均衡 / 跨节点 KV 与 stage 流水 / iroh
- 08 投机解码:事务化 verify / MTP 与 DSpark 形态 / 围栏交互 / 实证纪律