
为什么我只输入了一句话,却消耗了数十万 Token?
用户只输入一句话,Agent 却可能先向模型注入数十 K 甚至更多上下文。本文从 Claude、Codex 的真实请求链路出发,讲清三种 HTTP 接口、cache hit、显存/SSD 两级前缀缓存和工具调用围栏。
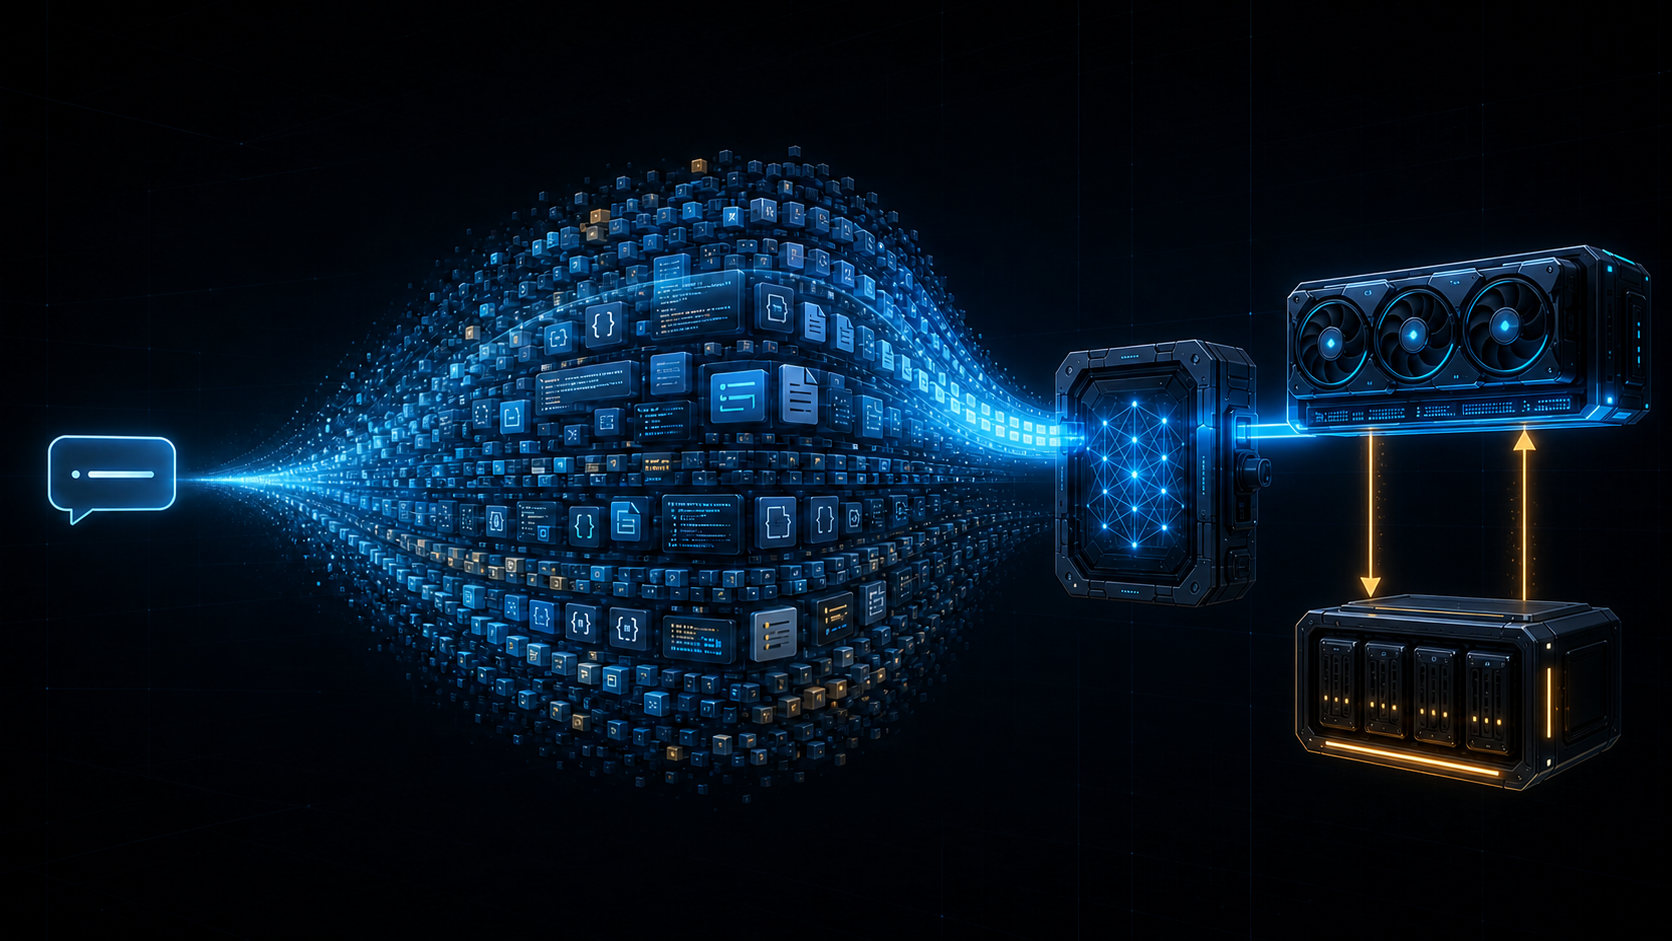
一句简短输入背后,是系统指令、工具定义、项目上下文和历史组成的巨大 token 流。热状态留在显存,淘汰时备份到 SSD,需要时再恢复回显存。
你明明只输入了一句话,账单或用量统计里为什么会出现数万、十几万甚至数十万 input token?
因为 Claude Code、Codex 这类 Agent 调用后台大模型时,发送的从来不只有输入框里那句话。在真正请求模型之前,客户端会先组装一份完整的“工作上下文”:系统指令、开发者规则、工具说明、JSON Schema、当前目录和项目约束、对话历史、之前的工具调用与结果,以及为了继续任务而保留的文件片段或摘要。你的话可能只有 20 个 token,但它只是一个巨大 prompt 的最后一小段。
换句话说,Agent 每一轮都要先让后台模型知道三件事:你是谁、你能做什么、现在已经发生了什么。 这些知识不是写进模型参数的训练,也不会被模型永久记住;它们是本次推理请求中的上下文注入,下一轮通常还要再次携带。工具越多、规则越长、历史越深,请求的 input token 就越大。
这也是为什么前缀缓存如此重要。虽然客户端每轮看起来都重新发送了数十 K 的知识,但其中绝大部分与上一轮完全相同。如果服务端保存了这段 token 执行后的模型状态,就不必每次从第一个字重新计算。
大模型服务表面上很像一个普通的 HTTP JSON 服务:客户端发来消息,服务端不断返回 token。但真正开始兼容不同客户端、复用长对话、支持工具调用以后,问题很快就不再是“加几个路由”那么简单。
我们在 zLLM 中实现了三套当前最常见的接口:OpenAI Chat Completions、OpenAI Responses 和 Anthropic Messages;在执行层实现了显存与 SSD 两级前缀缓存;在生成层又为 DeepSeek DSML 工具调用加入了 token 级围栏。它们表面上是三个功能,实际都在解决同一个问题:协议状态、模型看到的 token,以及设备中保存的计算状态必须严格对齐。
这篇文章不只介绍最终设计,也会把过程中踩过的坑讲明白。
一句话背后的数十 K 上下文
一次典型的 Claude Code 或 Codex 请求,可以粗略拆成下面几部分:
| 上下文组成 | 里面有什么 | 为什么每轮可能重复出现 |
|---|---|---|
| 系统与开发者指令 | 身份、安全边界、回答格式、编码规范、工作流程 | 模型本身不会跨 HTTP 请求记住这些规则 |
| 工具定义 | shell、文件、搜索、浏览器等工具的名称、描述和参数 Schema | 模型必须知道有哪些动作以及怎样合法调用 |
| 工作区知识 | 当前目录、仓库规则、AGENTS.md、环境与权限信息 | Agent 需要在正确项目和约束下行动 |
| 对话历史 | 用户要求、模型分析、已完成步骤与中间结论 | 保持多轮任务连续性 |
| 工具调用和结果 | 执行过的命令、读取的文件、错误日志和返回数据 | 后续判断依赖这些观察结果 |
| 当前输入 | 你刚刚键入的那一句话 | 通常只是整个 prompt 的尾部 |
“数十 K 的知识先灌输给模型”说的就是这个过程。这里的 K 是千 token:10K 约等于一万个 token。它不等于一万个汉字,因为 tokenizer 会把文本、标点、路径、代码和 JSON 按各自规则切分。尤其是工具 Schema,字段名、描述、枚举、嵌套对象和协议样板都会计入 input token;同时启用几十个工具时,仅工具说明就可能占据非常可观的上下文。
客户端界面往往只展示用户消息和最终回答,所以这部分成本很容易被误解为“模型偷偷生成了几十万 token”。实际上,用量通常至少分成三类:
input_tokens:本轮送进模型的完整上下文,不只是用户新输入;cached_tokens:input 中已由服务端复用计算状态的前缀;output_tokens:模型本轮新生成的 reasoning、正文或工具调用。
不同服务商如何计费要以各自规则为准,但在计算语义上,cached_tokens 仍然属于输入上下文。它表示这些 token 确实在 prompt 中,只是服务端没有重新完成同样的 prefill 计算。于是会出现一个看似矛盾、其实完全合理的现象:本轮 input token 仍有十万,但真正重新计算的输入可能只有最后几百个 token。
如果缓存没有命中,这十万 token 就要重新经过完整模型的每一层,首 token 延迟会明显增加;如果缓存命中,服务端恢复旧状态,只对新追加的用户消息和 assistant 起始部分做 append prefill。这正是本文后半部分显存与 SSD 两级前缀缓存要解决的问题。
三种主流接口,差异不只是 JSON 字段名
zLLM 对外提供三个主要入口:
| 接口 | 典型客户端 | 输入核心 | 流式输出 | 会话续接 |
|---|---|---|---|---|
POST /v1/chat/completions | OpenAI SDK、通用聊天前端 | messages | Chat chunk SSE | 客户端重传完整历史,可携带 cache 标识 |
POST/GET /v1/responses | Codex、ZCode、新版 Agent 客户端 | input item | Responses SSE 或 WebSocket event | previous_response_id |
POST /v1/messages | Claude Code、Anthropic SDK | system + messages | Anthropic event SSE | 客户端重传历史 |
三者最终都会变成同一种内部任务:结构化消息经过模型自己的 chat template 变成 token,随后执行 NewPrefill、AppendPrefill 和 DecodeRound。但协议适配层不能只做字段重命名。
Chat Completions:最直接,也最容易成为内部公共形态
Chat Completions 的核心是有序 messages。工具统一采用 OpenAI function tool 形态:
{
  "model": "deepseek-v4",
  "messages": [{"role": "user", "content": "查一下上海天气"}],
  "tools": [{
    "type": "function",
    "function": {
      "name": "get_weather",
      "parameters": {
        "type": "object",
        "properties": {"city": {"type": "string"}},
        "required": ["city"]
      }
    }
  }],
  "stream": true
}
非流式响应把文本和 tool_calls 收拢到一个 assistant message;流式响应则要保持 tool call 的 index、id、函数名和参数增量稳定。这里有一个容易忽略的问题:工具调用 ID 不能只由工具名生成,否则同一工具在不同请求或同一响应中多次调用会发生碰撞。我们的做法是把请求级 scope、调用序号和工具名一起哈希。
Chat Completions 很适合作为服务内部的规范形态,因为角色消息、工具定义和采样参数都比较直接。Responses 和 Anthropic 请求进入服务后,会先严谨地转换成这一公共结构,再交给 scheduler 和 runtime。
Responses:它是事件协议,不是换皮的 Chat
Responses 的输入不是单纯的消息数组,而是 input item 流。它可以包含普通 message、function_call、function_call_output、图片输入,以及 Codex Responses Lite 放在输入前缀中的 additional_tools。后者还可能用 namespace 包裹真正可执行的 function,因此转换时要展开 namespace,同时跳过当前无法本地执行的托管工具类型。
输出同样不是一个不断增长的 delta.content。文本、reasoning 和 function call 是不同的 output item,各自有生命周期事件:创建、增量、完成,最后才是整个 response 的 completed 或 failed。尤其是 reasoning,必须作为独立的 output[type=reasoning] 暴露,不能混进正文,否则 Codex 一类客户端无法正确渲染和恢复状态。
我们同时支持两种传输:
- HTTP POST + SSE,适合普通 SDK;
GET /v1/responses升级为 WebSocket,一条连接串行复用多次response.create,适合长时间运行的 Agent 客户端。
previous_response_id 也值得单独说明。zLLM 会持久化上一轮的协议消息和 cache key,因此进程重启后仍能恢复对话链;但它本身不持有模型 KV。协议历史恢复成功,只代表我们能重建完整输入,不代表设备缓存一定还在。随后是否命中显存或 SSD cache,仍由 runtime 独立判断。
Anthropic Messages:内容块和事件顺序必须原样成立
Anthropic Messages 把 system 放在顶层,正文由 content block 组成。工具定义使用 name、description、input_schema,工具调用和结果则分别是 tool_use 与 tool_result block。适配层需要把它们双向转换成内部 function tool,而不是把 block 粗暴拼成字符串。
流式响应的事件顺序也有严格语义:先 message_start,再打开一个 content_block_start,发送对应 delta,关闭 block,最终发送 message_delta 和 message_stop。文本与多个工具调用可能占据不同 block index;如果只把 Chat SSE 的字段名改掉,客户端会得到顺序错误或无法闭合的内容块。
Claude CLI 还会调用 /v1/messages/count_tokens 判断何时自动压缩上下文。这个接口即使只是估算,也必须读入 system、messages 和 tools,而不能只数用户正文,否则压缩触发点会严重偏后。
cache hit 到底意味着什么
在推理服务里,cache hit 不是“找到了相似问题”,也不是“直接返回上次答案”。它的精确定义是:
新请求 token 序列的开头,与某个已保存会话的 token 序列逐 token 完全相同,因此可以恢复这一前缀执行完后各层的 KV、DSA/MTP 等模型状态,从前缀末尾继续计算。
假设上一轮终点状态对应:
[system][tools][user-1][assistant-1]
新一轮输入是:
[system][tools][user-1][assistant-1][user-2][assistant-prefix]
|<----------- cached_tokens ----------->|<-- append prefill -->
命中后,前面 cached_tokens 个 token 不再重新通过完整 Transformer;只对新增后缀执行 append prefill,再进入 decode。它降低的是 TTFT 和重复 prefill 计算,不会消除新问题的 decode,也不会缓存答案。
这一定义有几个重要后果:
- 必须是 token 前缀相等,不是文本“看起来一样”。 空格、JSON 序列化方式、工具 schema 顺序、thinking 开关、chat template 或特殊 token 变化,都可能让前缀分叉。
- cache ID 是定位提示,不是正确性凭证。 即使客户端给出精确 ID,runtime 仍要检查 token 前缀与 namespace;不匹配就回退到最长前缀或冷启动。
- 命中长度必须小于新 prompt 长度。 如果直接把一个完整终点当成待执行输入,却没有新增 token,模型没有合法的 append 边界。
- cache hit 不是 cache resident。 命中的状态可能在显存,也可能已经换出到 SSD。二者节省的计算相同,但恢复延迟完全不同。
我们为 terminal cache 计算稳定身份时,不只包含用户消息,也包含模型、模板相关请求、assistant 输出和结构化 tool calls。否则“屏幕上看起来相同”的两轮请求可能错误共享不兼容的模型状态。
为什么要做显存与 SSD 两级存储
长上下文 KV 很贵。以数万到数十万 token 的 Agent 对话为例,保留每个历史分支的设备状态能显著减少重复 prefill,但显存不可能无限增长。只做 LRU 删除又意味着刚淘汰的长对话下一轮要从头算起。
我们的两级机制可以概括为:
请求到达
  ├─ 精确 cache_id 命中显存 ────────┐
  ├─ 显存中搜索最长 token 前缀 ─────┤
  ├─ 精确 cache_id 命中 SSD ────────┤→ append prefill → decode
  ├─ SSD 中搜索最长 token 前缀 ─────┤
  └─ 都未命中 → new prefill ────────┘

显存层:可直接继续计算,容量小,延迟最低
SSD 层:保存压缩快照,容量大,需要读盘和 H2D/设备恢复
一级:显存中的 resident terminal cache
每次请求成功结束后,引擎保留终点 session,其中包括 token 序列、namespace、父节点/轮次关系和模型私有执行状态。公共 cache 层只负责所有权、前缀图和淘汰;具体有哪些 KV、压缩环、DSpark target cache,由模型 runtime 自己定义。
这里必须有真实的驻留预算,而不能只限制“最多保存 N 个会话”。两个 token 数接近的会话,占用也可能相差数倍:除线性 KV 外,还有 recent/compressed 环、batch scratch、推测解码 block 和 target cache 等固定或阶梯式开销。我们最终按真实 allocated_bytes 做 admission 和诊断,并在请求开始前预留后续 decode 仍会增长的容量。
缓存还不是一条简单 LRU 链。Agent 对话会从同一个历史点分叉,因此内存层维护共享前缀 block graph:父状态可以被多个后继复用,只有不再需要的分支才真正释放。terminal_cache_prefix_rounds 控制保留多少轮祖先,避免每个中间终点永久占据设备。
二级:SSD 上的可恢复快照
显存淘汰一个值得保留的终点时,runtime 下载模型状态,按模型版本编码成快照,写入 SSD。索引中保存 cache ID、完整 token 序列、namespace、轮次、head 标志、设备驻留字节数和 blob generation;大块 KV 数据采用分块存储。
写入必须具有提交边界。manifest 只能在数据 blob 完整落盘后切换到新 generation,这样进程崩溃时不会留下“索引存在、内容不完整”的半份缓存。读取端把磁盘内容当作不可信输入:所有长度、计数、版本和剩余字节都要检查,不能让损坏快照触发越界或巨量分配。
SSD 命中后,引擎优先复用已经分配过的空 session buffer,把各 stage cache 上传回设备,并恢复 DSpark 等附属状态。恢复完成后设置 next_prefill = cached_tokens.len(),只计算新增部分。
SSD 层也支持最长前缀搜索,而不是只能依赖 ID。搜索条件仍然是严格的 tokens.starts_with(snapshot.tokens),并且要隔离 namespace。为了排查“几乎命中却没命中”的线上问题,我们会记录公共前缀超过 1024 token 且覆盖旧快照 90% 以上的 near miss;这种日志通常能直接暴露模板、工具回显或序列化分叉。
两级缓存实现中真正棘手的问题
1. 淘汰顺序与 admission 死锁
最早的实现先为新请求申请显存,再淘汰旧 cache。结果是明明有可淘汰状态,却因为预算不足拒绝新请求。正确顺序是先识别可牺牲的 resident cache,完成必要的换出和释放,再做 admission;同时为 decode 增长预留空间,避免 prefill 恢复成功后在生成中途耗尽显存。
2. 异步恢复并不等于可以提前开始计算
SSD 读取、CPU 解码和多 GPU H2D 可以并行,但依赖关系不能省略。我们遇到过 restore 任务仍在写设备 cache,计算流已经开始读取的情况;也遇到 cache open 命令没有 drain 就复用资源。修复不是“多加一个全局同步”,而是为每个 stage 明确 restore 完成事件,只让互不依赖的 I/O 与上传并行,在第一次消费前等待对应依赖。
3. reusable pool 也会泄漏
如果每次 SSD 恢复都新建 session,旧设备 buffer 虽然进入 reusable pool,却长期没有机会被拿出来,显存仍然越堆越高。恢复路径必须优先从 pool 取一个 session 并覆盖其 cache;失败和取消路径也必须 reset 后归还,而不是只处理成功请求。
4. 工具回显是缓存链最常见的断点
工具调用经历“模型原生文本 → API 结构化 tool call → 客户端执行 → 下一轮历史重新编码”。只要正向解析和历史重放不互为逆操作,下一轮 token 就会在工具位置分叉。我们曾遇到 DSML terminal cache 续接失败,根因正是工具标签、参数字符串/JSON 类型或大小写规范化后的回显不一致。
解决方法是让每种 ToolDialect 同时拥有四个能力:注入 instructions、渲染历史 tool call、渲染 tool result、解析模型输出。它们必须来自同一个协议实现,不能散落在 HTTP 层和各个 backend 中。
工具调用围栏:为什么事后解析还不够
仅靠 prompt 告诉模型“请输出合法 JSON”并不可靠。模型可能生成不存在的工具名、重复参数、漏掉 required 字段、在 JSON 中提前输出闭合标签,或在长推理后陷入重复。等整段文本生成完再解析,只能宣布失败,无法挽回已经浪费的 decode。
因此我们把工具支持分成三层:
- 协议提示与历史渲染:把统一 function schema 编码为模型训练时熟悉的 GLM XML、ChatML JSON 或 DeepSeek DSML。
- 增量解析:流式识别正文和工具区域,把合法调用转换成统一
tool_calls,同时避免把半个标签提前泄露给客户端。 - token 级生成围栏:在采样之前,根据当前语法状态强制或排除候选 token,使结构化区域只能沿合法路径生成。
第三层才是“围栏”的核心。以一个指定的 DeepSeek DSML 工具为例,状态机依次经过:
固定 tool_calls/invoke 前缀
        ↓
选择一个尚未出现的参数
        ↓
按该参数 JSON Schema 生成值
        ↓
参数闭合;required 是否齐全?
        ├─ 否:只能继续选择参数
        └─ 是:允许闭合 invoke/tool_calls
固定标签、工具名和参数名由围栏强制下一个 token;参数值由 JsonSchemaFence 给出允许集合;每个参数只能出现一次;required 未齐全时,结束标签根本不会进入候选集。字符串参数还要排除会意外打开 markup 的 token,终止 token 在结构未完成时同样被禁止。
tool_choice=auto 更复杂:模型在普通正文阶段应保持自由,只有检测到 DSML trigger 后围栏才激活。激活时可能仍有多个候选工具,状态机并行推进所有仍与已生成 token 相容的分支;候选收敛到一个后,再使用该工具的参数 schema。这里不能一开始就强迫模型调用工具,否则 auto 会被错误实现成 required。
围栏位于 output head 与采样之间。普通 decode、batch 中的每一行、MTP/DSpark draft 和 speculative verify 都必须应用同一份请求级围栏状态。漏掉任何一条路径,就会出现“不开推测解码时正常,一开就偶发非法工具 JSON”的问题。
围栏实现中踩过的坑
tokenizer 边界不是字符串边界
标签 </...> 在 tokenizer 中可能跨 token,也可能共享一个 </ token。围栏不能假设每个字符或标签都是独立 token。初始化时要用当前模型 tokenizer 编码所有 literal,并验证闭合片段的首 token 与预期边界一致;不一致就拒绝启用,而不是在生成中途进入不可达状态。
auto 分支不能取错误的交集
多个候选工具的下一 token 可能不同。正确的允许集合是所有仍合法分支的并集;只有所有分支都禁止某 token 时才能排除它。如果把排除集合简单合并,就会过早杀死仍然合法的工具分支。每生成一个 token 后,还要淘汰与它不相容的候选状态机。
draft token 也要逐个推进临时状态
推测解码一次提出多个 token。不能只拿当前围栏验证整段,也不能让草稿直接推进正式状态。正确做法是 clone 一份 guard,逐 token 计算该位置的 fence 并推进 probe;target verify 通过的前缀提交后,再推进正式状态。若围栏已经强制某些 token,还可以直接构造这些位置,避免无意义的 logits 计算。
协议修复不能只靠 parser 打补丁
我们处理过大小写不一致、转义的 DSML 标签和游离闭合标签。parser 的容错能兼容已有模型输出,但如果问题属于可预知的结构错误,更根本的修复仍然是采样前围栏。否则非流式看似“被修好了”,流式过程中却可能已经把错误片段发给客户端。
围栏还要与失控循环保护组合
工具语法约束解决“结构非法”,不解决模型在 thinking 中重复同一段内容。zLLM 的 GenerationGuard 会检测重复 token、重复模式和带证据的语义重启,在下一次采样时排除已知会继续循环的 token;若 speculative batch 内已经发现循环,则截断已验证行,必要时用 reasoning-end token 收口。工具围栏和循环保护最终合并成同一个 TokenFence,但两者保持独立状态机,避免协议逻辑污染通用生成层。
一条请求最终如何穿过整个系统
把三套接口、两级缓存和工具围栏放在一起,一条真实请求的路径是:
Chat / Responses / Anthropic request
        ↓  协议校验与规范化
统一 messages + function tools
        ↓  模型 dialect/template/tokenizer
完整 prompt tokens + cache identity
        ↓
显存精确/最长前缀 → SSD 精确/最长前缀 → 冷启动
        ↓
NewPrefill 或 AppendPrefill
        ↓
output head → 请求级 token fence → sampling/speculative verify
        ↓
原生工具流增量解析
        ↓
Chat chunks / Responses events / Anthropic content blocks
        ↓
成功终点写入 resident cache,淘汰时持久化到 SSD
这条链路中,HTTP 层不拥有 KV,cache 层不理解模型协议,backend 不认识工具名,模型 runtime 也不负责某一种外部 SSE 格式。每一层都只保存自己必须知道的语义,但边界上传递的是可验证的真实状态,而不是一个含糊的“会话 ID”。
最后的判断标准
前缀缓存是否正确,不看日志里有没有打印 hit=true,而要验证恢复后的 token、position、各层 KV 和附属状态与完整 prefill 一致;收益则看真实 TTFT,而不是只算跳过了多少 token。
工具调用是否正确,也不看最终字符串能否被一次 JSON parser 接受,而要验证流式事件顺序、历史回放、下一轮 cache 续接,以及普通 decode、batch、speculative 路径是否都执行了同一语法约束。
我们最终得到的经验很朴素:接口兼容的终点不是 JSON 长得像,缓存命中的终点不是 ID 对得上,结构化生成的终点也不是事后能修。 真正可靠的实现,必须一直落到模型实际看到的 token 和设备实际保存的状态上。