
DeepSeek V4.1 Flash 的 Engram:让知识不必每次重新算
ROCm 工程实践:从记忆检索到 AVX-512、NUMA 与 CPU/GPU 协同
在我们看来,DeepSeek V4.1 Flash 是一部大模型工程化的杰作。 它将图文理解、稀疏专家、压缩稀疏注意力与 Engram 条件记忆组合起来,让模型的知识容量、计算量和运行时资源有了更细致的分工。
其中最值得展开的是:哪些信息需要结合上下文计算,哪些局部模式可以从训练好的记忆中检索,哪些中间结果能够在多层之间共享。这些设计直接影响推理时要读多少权重、保留多少历史,以及哪些工作可以提前完成。真正接入一个推理引擎,才能体会这些细节如何共同支撑完整模型。
这个系列将从 zLLM 的实际接入过程,逐篇拆解这套设计。我们首先做了一个资源放置决定:Engram 的大表与投影留在主机侧,主干网络继续交给 GPU。 最初门控也在 CPU 上完成,后续优化再把 prefill 的门控移回 GPU。
这个决定贯穿了后面的工作。权重怎样读、每个 token 在什么时候进入记忆状态、跨卡执行时状态怎样传递,以及图像位置能不能参加文本查表,都需要落实到推理链路里。
截至 2026 年 9 月 14 日,zLLM 已在八张 W7900D 上,用官方 safetensors 权重跑通图文请求到文本生成的完整流程。当前已验证的文本性能为:50K 输入约 26.06 秒出首字,单路生成约 20.45 token/s。这些是单路、关闭 DSpark 的文本测试结果:前者对应 50,032-token 输入的平均首字延迟,后者对应 25-token 提示下连续生成 700 token 的平均速度。系列第一篇完整讲解 Engram 的原理与工程优化;其他模型组件和完整性能表留到后续各篇。
基于内存的知识——Engram
上半部分不依赖当前层 hidden,可提前查表和投影;下半部分等待 hidden 后完成门控。图中的两组 key/value 表示同一份投影结果。
为什么有些东西值得记住,而不必每次重新算
语言模型的计算中,一部分用于理解新上下文、组合信息和推理;另一部分用于重新构造已经见过很多次的局部模式,例如常见词组、固定搭配和实体名称的表示。传统 Transformer 将这些能力共同编码在网络权重里,每次遇到输入,都要通过网络计算把相关表示重新建立起来。
Engram 尝试让其中适合记忆的部分直接通过检索获得。训练过程中,一部分可复用的局部模式被学进 n-gram 记忆表;推理时,根据 token 组合找到表行,取出已经学好的向量,再由当前上下文决定如何吸收。官方的机制分析认为,这能减轻早期层重建静态模式的负担,为复杂推理保留更多有效深度。Engram 官方研究说明
可以用一个直观例子理解:模型遇到一个熟悉的多 token 专有名词,记忆表可以提供与这个局部组合有关的已学习特征,后续网络再判断它在当前句子里扮演什么角色。这是机制上的示意,并不表示某一行一定对应一条可读事实,也不表示我们已经验证了某个词组具体落在哪个桶。
原来需要网络反复构造的一部分表示,现在有了一条直接查表取得的路径。 这里的“提取潜在知识”,更准确地说,是训练让部分知识和模式由专门的记忆参数承载;zLLM 加载已有权重并执行检索,没有在接入时从旧模型里额外抽取一套知识库。
减少计算负担,与减少显存占用,是两个环节
在模型设计上,Engram 将部分静态模式的重建工作交给条件记忆。记忆表很大,但每次只访问固定数量的行,扩展容量不需要每个 token 扫描整张表。它改善的是记忆容量与计算量之间的关系;我们不能据此声称给现有 V4.1 关闭 Engram 就会更慢,或启用它后自动少执行几层 Transformer。
在引擎实现上,zLLM 利用这种稀疏访问,把大表放在主机内存。显存因而不必承担整张 Engram 表的存储,可以留给主干权重、专家、KV cache 和临时张量。节省的是原本将同一张表完整放进显存的容量,整机仍然需要承担这份记忆的存储成本。
两层表按约 3.84 亿行 × 256 维 × 2 层 计算,仅每值一个字节的代码数据就约为 183 GiB,还没计入 scale。这是根据张量规模计算的容量,说明放置策略的重要性,并非本次 RSS 或显存节省量的实测。相比之下,一次 token 在两层各取 24 行,代码数据合计只有 12 KiB;操作系统实际访问以页为单位,后续还有投影读权重,不能把 12 KiB 当成整步内存流量。
查表也不是完整答案。向量仍要经过 WKV 投影和上下文门控,模型还要继续完成主干推理。因此,我们后面的优化分成几个独立环节:减少小行读取开销、提高投影效率、让线程靠近数据,以及提前执行不依赖 hidden 的工作。
把知识变成可寻址的向量
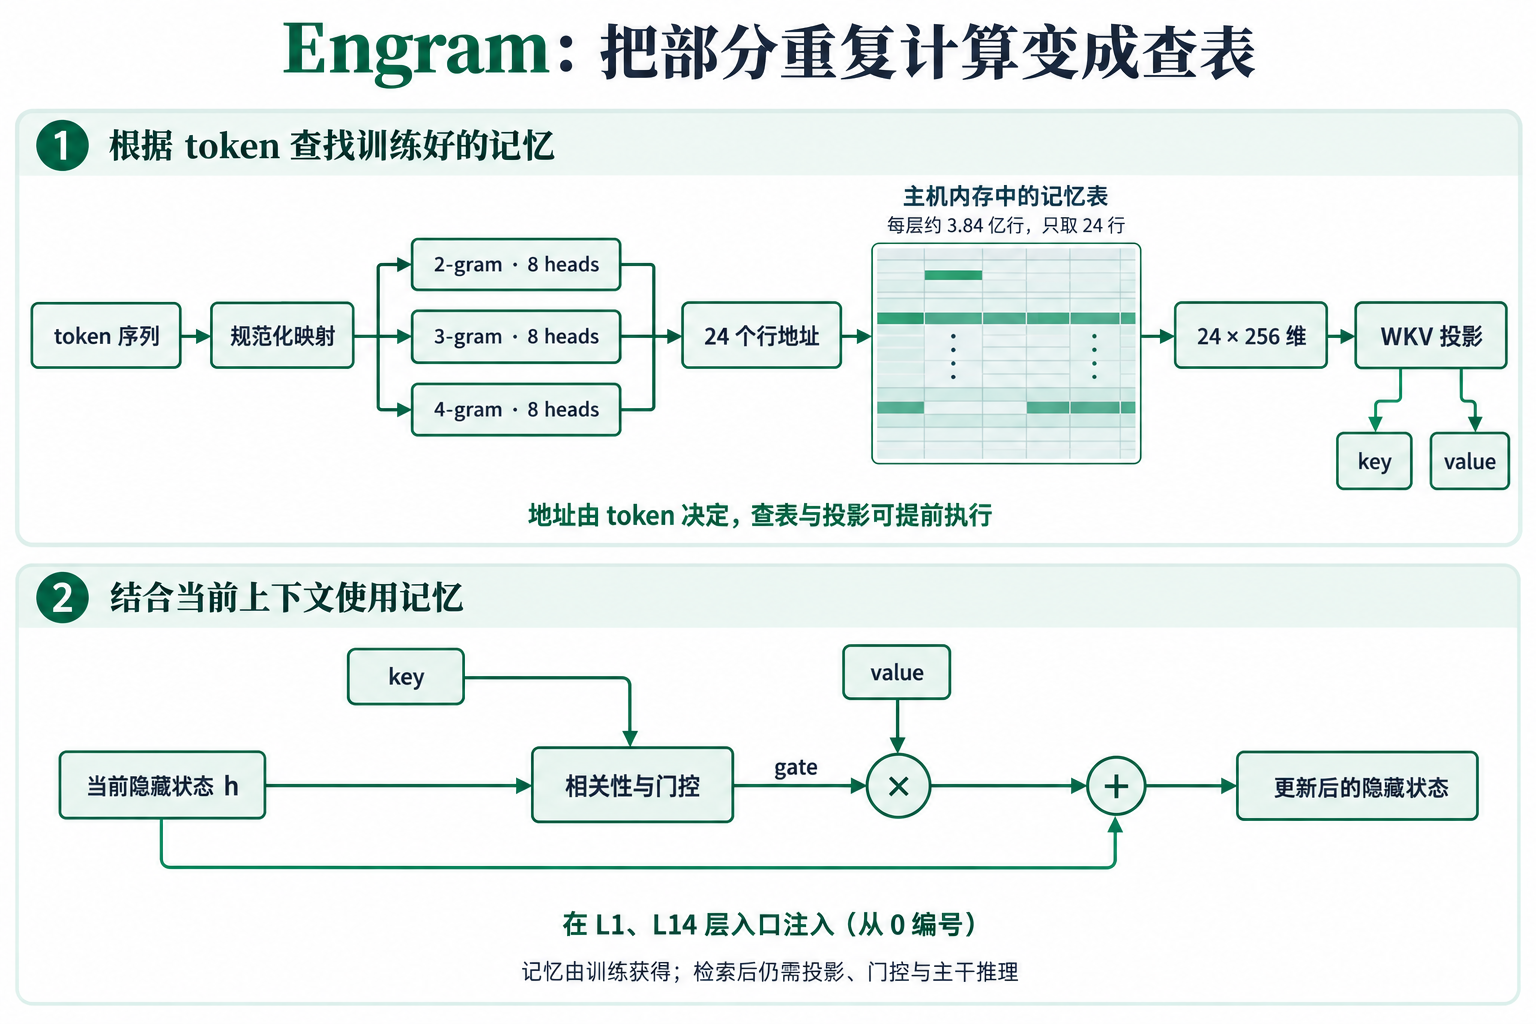
Engram 给模型增加了一条由 token 序列触发的记忆读取路径:根据当前位置附近的短序列计算地址,从训练好的大表里取出向量,再结合当前隐藏状态决定注入多少。
这里的“知识”以模型参数中的向量形式存在。它没有供人直接编辑的词条,也不会在一次聊天后自动把新事实写回权重。我们可以把它理解为模型内部的一种条件记忆:输入决定查哪里,当前上下文决定如何使用查到的内容。
我们接入的配置在 L1 和 L14 放置 Engram,层号从零开始。每个位置分别构造 2-gram、3-gram、4-gram,每种长度有 8 个 hash heads,共查 24 行,每行 256 维。
因此,每个 Engram 层针对一个 token 取出的向量共有:
3 种 n-gram 长度 × 8 个 head × 256 维 = 6,144 个值
每层表约有 3.84 亿行,但一次访问只涉及其中 24 行。总容量很大,单步读取很稀疏,这正是我们把它放在主机侧的出发点。
第一步:先把查表地址算对
最先需要对齐的是 token 到地址的映射。官方实现会先规范化 token 文本,再把规范化结果相同的 token 合并到同一个压缩 ID。大小写、重音和空白处理都会影响最终地址;压缩词表大小还会影响 hash 乘子的生成。官方 Engram 实现
zLLM 的做法是沿用官方生成规则,把压缩 token map 离线导出为 engram_token_map.bin,运行时读取;每层使用的乘子、素数桶和桶偏移则展开为静态表。当前映射包含 129,280 个 u32。
运行时的路径很直接:
token ID
  → 压缩 token ID
  → 当前 token 与最近三个位置
  → 2 / 3 / 4-gram 的 24 路 hash
  → 对应 Engram 层的 24 个表行号
这一步错了,后面依然可能得到形状正确的向量,但取到的已经是另一组记忆。接入时因此先对齐 hash,再验证投影和门控。
第二步:大表按行读,投影留在内存里算
当前权重层的 engram_embedding_rows 只读取选中的行。官方表使用 MXFP8,即 E4M3 数据加按 32 个值分组的 E8M0 scale;读取数据时也读取对应的 scale,然后在 CPU 上解码这 24 行。
最初接入版本通过文件偏移逐行读取,热数据由操作系统页缓存承接,冷访问可能触发存储读取。后续优化分支改成只读 mmap,并在加载阶段逐页预热;这一演进在下文的读取优化中展开。预热不等于锁页,内存压力下页面仍可能被回收。
投影等计算权重显式保存在内存里。查出的 6,144 维向量经过 wkv 投影,产生后续门控需要的 key 和 value。每层 wkv 的形状为 25,600 × 6,144,在准备阶段转为 BF16,约占 300 MiB。最初使用 AVX2/FMA 和 Rayon 行并行,后续换成 AVX-512 BF16 与固定线程组。
这也解释了为什么“只查 24 行”不等于 Engram 没有成本:查表之后还要读取一块较大的投影矩阵。把它留在 CPU 上,节省了显存,同时把这部分压力交给主机内存带宽。实际延迟还受冷读、线程调度和 CPU/GPU 同步影响,需要独立测量。
第三步:在正确的层入口注入
Engram 在 L1、L14 的入口修改隐藏状态,此时隐藏状态仍是 mHC 展开后的多路表示。
CPU 实现先算出 key 和 value,再对每一路隐藏状态分别求门控。隐藏状态和 key 各自计算归一化因子,得到相关性分数 dot,然后执行:
gate = sigmoid(copysign(sqrt(max(abs(dot), 1e-6)), dot))
hidden += gate × value
门控决定当前上下文要吸收多少记忆。实现中把 q、k 的逐元素权重预乘保存,各路仍分别计算自己的归一化与 gate。
最初接线通过层入口 hook 调用 CPU Engram,再让更新后的隐藏状态继续进入 GPU 主干。优化版本把查表、投影、门控拆开:大表和投影保持在 CPU,prefill 的预计算结果交给 GPU 门控,decode 则仍可在 CPU 上完成门控。执行位置会随路径而异。
第四步:让记忆状态跟随会话
每个 token 只应进入 hash 历史一次。运行到两个 Engram 层时,各层读取同一个位置的历史,使用自己的 hash 参数。若在每层重复追加 token,后续 n-gram 就会错位。
zLLM 因此把追加 token 和应用 Engram 分开:prefill 追加一段,decode 每次追加一个;L1、L14 的 hook 只使用已经建立的位置状态。
权重可以共享,序列历史需要隔离。当前实现通过 Arc 共享投影权重,会话 fork 时创建新的 hash 状态,reset 时清空历史。后续的会话隔离修复,是让这个模块能够进入服务运行的必要步骤。
图像接入后,这条规则又多了一个边界:图像 span 写入 DEAD 标记,阻断跨图像位置的文本 n-gram;图像行本身还要跳过 Engram 门控。我们在多模态对拍时补齐了这两项,避免把图像占位符当作普通文本记忆的输入。
读取优化——从逐行 pread 到 mmap 预热
初版按行读取足以验证正确性,但一行只有 256 个量化值,数据和 scale 分别读取时,会产生大量小粒度文件调用。prefill 又把这个过程重复到整段 token 上,小请求的固定成本逐渐显现。
优化提交 e9b539e4 为 safetensors 增加只读 mmap。推理时从映射区域取选中的行,减少逐行 pread 的系统调用;数据仍保留量化形式,大表没有整表反量化为 F32。
加载阶段还会对 Engram 的数据和 scale 做预热:先提示顺序访问与预读,再逐页触碰,最后恢复 MADV_RANDOM,使运行时按随机查表模式访问。这样把一部分首次缺页和存储读取移到装载阶段。代价是启动时间与主机内存占用,收益需要在服务热态测量。
这条路径没有使用 mlock。mmap 本身也不保证页面已经进入 RAM;真正预热来自显式触页。描述运行状态时,需要同时核对内存压力和页面驻留,不能仅凭映射成功就认定整张表始终常驻。
AVX-512 BF16——让一份权重服务多个 token
初版的瓶颈:重复扫描 WKV
初版投影是一行 token 对应一次 GEMV。WKV 的 BF16 存储已经减少了权重字节数,但 prefill 若逐 token 调用,仍会重复扫描同一份约 300 MiB 的矩阵。
优化的重点因此是把多个 token 放进同一次矩阵乘,让加载进来的权重在一组输入之间复用。AVX-512 BF16 是实现这件事的指令基础,批量与布局决定能否发挥它的作用。
按 16 个输出与 BF16 对打包
优化后的 WKV 按下面的顺序保存:
[输出块][输入维度对][16 个输出通道]
每个 u32 装两个 BF16 权重。内层一次加载 16 个输出通道对应的权重对,再广播某个 token 的两个输入值,调用 _mm512_dpbf16_ps,以 F32 累加到 16 个输出。多个 token 各自保留累加器,共用这一次加载的权重。
已检查的版本按 30、16、8、4、2、1 行处理输入块和尾部。30 行块意味着同一份加载可以服务最多 30 个 token;decode 只有一行时不会凭空获得这份批量复用收益。
输入也要配合内层访问顺序
输入改成 [输入维度对][token 行] 的 pair-major 布局。同一对维度在多个 token 上的值相邻,减少按 token 大跨度跳读。官方 MXFP8 表行还可以直接解码成这份 BF16 packed 输入,省去先完整展开 F32、再转 BF16 的中间过程。
这一步实际遇到过布局错误:每个 token 的输入来自 24 个 head,合并时必须保留 head 与 pair 的对应关系。只改打包方式、不同时核对消费者索引,可能产生维度合法而内容错位的输入。因此补充了 packed MXFP8 与 F32 解码路径对照,以及批量 BF16 与 scalar reference 对照。
代码在运行时检查 avx512f 和 avx512bf16,支持时使用对应 kernel。它改变了输入精度处理与累加方式,不能只凭算子跑得更快就断言输出完全相同。局部 reference 测试、真实输入生成和端到端性能要分别验证。
NUMA 绑定——线程和权重一起放
矩阵乘要连续读取大块权重,线程所在 CPU 与页面所在内存节点的关系就很重要。若工作线程在一个 socket,数据大量位于另一个 socket,跨 socket 访问可能抵消向量化收益。
先识别允许使用的物理核
当前实现先调用 sched_getaffinity,只考虑进程允许使用的 CPU;再从 sysfs 读取 physical_package_id 和 core_id,按物理 package 分组,并去除同一物理核的 SMT 重复项。双 package 情况下,L1、L14 分别使用不同的 CPU 组。
这里代码实际按 package 分组。它符合本次双路机器的放置思路,但不是任意硬件上都成立的完整 NUMA 拓扑求解:一个 socket 也可能被配置成多个 NUMA node。迁移机器时必须核对拓扑,不能把 socket 和 NUMA node 永远画等号。
用固定 worker 替代临时分配任务
每层创建持久的 EngramTeam,worker 启动时绑定到选定 CPU。每个 worker 处理固定区间的输出块,空闲时 park,收到任务后唤醒,完成后通知提交方。这样把线程位置与工作分片固定下来,减少通用线程池动态调度造成的迁移和局部性变化。
选核也没有占满所有物理核:一个 package 至少有 16 个可用物理核时,只取其中四分之三。例如完整可用的 32 核 package 会选 24 核,给 GPU 提交、传输和服务线程留出余量。这是给其他工作保留调度空间,不等同于通过 cpuset 强制保证它们只运行在剩余核上。
装载与 first-touch 要跟着计算位置走
WKV 重排由对应的固定 worker 直接写入最终 packed 缓冲区,让首次写页发生在后续使用这些分片的 CPU 上。大表预热也会临时绑定到该层 CPU 组中的一个核,再触碰映射页面。
这是“线程绑定+数据首次访问”的组合。当前代码没有用 mbind 强制迁移已有页面;若文件页早已被其他进程载入,或系统另有内存策略,绑核触页不能保证所有数据重新放到目标节点。因此,它表达的是放置策略,实际效果还需检查页面分布和远端访问。
AVX-512 解决每次读取后如何高效计算,NUMA 放置解决这些字节从哪里读取,预留 CPU 则避免投影抢占 GPU 提交所需的主机资源。三者服务于同一条完整流水线。
投影结果上传,也要照顾消费它的 GPU
prefill 门控移到 GPU 后,投影结果还需要从 CPU 上传。测试发现,相同大小的结果,L1 上传约 15 ms,L14 却约 90 ms:L14 的 CPU 工作组与消费结果的 GPU 分属不同 NUMA 节点。
我们为上传增加靠近目标 GPU 的 pinned staging,让传输使用本地的页锁定中转缓冲。那一轮 50K 测试从约 26.67–26.84 秒降到 25.87–25.88 秒,输出哈希一致。这是该轮相邻实验的结果,最终性能表采用后续复测值。
绑定也需要实测。把全部 GPU 提交线程整体移到另一 NUMA 节点的实验,反而测到 28.47 秒,因而撤回。有效的 CPU 数据放置与上传中转优化,不能推广为“所有线程都按 PCIe 拓扑绑定就一定更快”。
提前投影——把 CPU 工作与 GPU 重叠
Engram 的查表地址只依赖 token 历史,WKV 投影只依赖查出的向量;只有门控需要当前层的 hidden。这个数据依赖允许把大块计算提前。
优化后在 stage 0 准备两层的 Engram batch,分别启动投影任务;GPU 同时推进主干,到 L1 或 L14 时再取得投影结果。若投影已完成,层入口只需执行后半段;尚未完成则仍要等待。L14 前面的主干工作更多,提供的潜在重叠窗口也更长,实际隐藏了多少时间需要 profile 证明。
prefill 使用预计算结果时,会把 key/value 投影结果交给 GPU 完成门控,使大批量 hidden 留在设备上。decode 的后续提交 153598f6 也提前启动投影,但保持 CPU 门控路径。因此这里减少的是层入口暴露的等待与部分数据往返,大表和 WKV 仍由 CPU 承担。
decode 提前投影的相邻 A/B 中,固定 25-token 提示、生成 700 token,平均速度从 19.417 提升到 20.454 token/s,提升 5.34%,完整文本哈希保持一致。完整性能表留在后续实测篇。AVX-512、NUMA、预热和流水线调整共同参与了 prefill 优化,整轮收益不能全部归因于某一项;prefill 的批量收益也不能直接外推到单 token decode。
后续预告
接下来按每天一篇的节奏,继续展开其他工程环节:
- 第二篇:从权重装配到八卡文本链路
- 第三篇:接入图像——用中间张量找差异
- 第四篇:性能实测——prefill、decode 与优化前后对比